← SCRAM AI Lab
Anthropic lanzó Opus 5.5 ($4/$20) y Sonnet 5.5 ($2/$10) en seis días. Sonnet supera a Opus en Terminal-Bench. Precios, cambios de API y cómo migrar.
October 6, 2026
16 lecturas
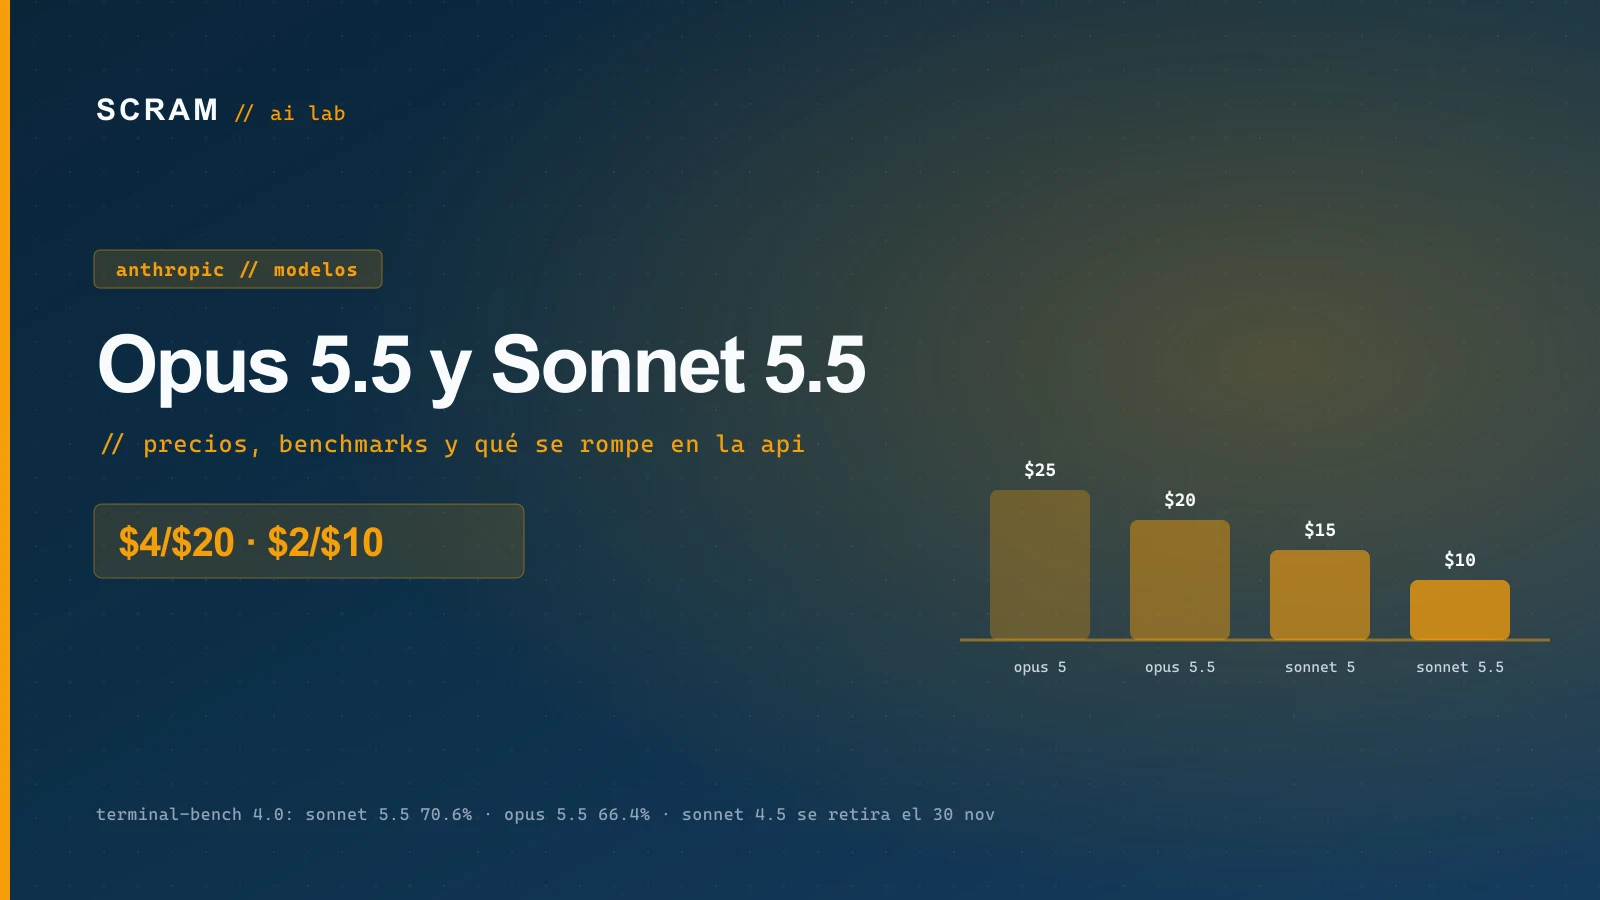
Anthropic lanzó dos modelos en seis días: Claude Opus 5.5 el 22 de septiembre de 2026 y Claude Sonnet 5.5 el 28. Los dos son más baratos que sus antecesores y, en la prueba de terminal que más se usa hoy para medir agentes de código, el Sonnet nuevo le gana al Opus nuevo. Para una empresa que usa Claude en producción, esto cambia qué modelo conviene en cada tarea y obliga a revisar el código antes de migrar, porque la API trae cambios que devuelven error.
Opus 5.5 cuesta $4 por millón de tokens de entrada y $20 de salida; Sonnet 5.5, $2 y $10. Los dos cobran la lectura de caché a $0.20. Así quedan frente al resto de la familia, según la página de Opus 5.5, la de Sonnet 5.5 y las notas de versión de la plataforma:
| Modelo | Entrada (USD/M) | Salida (USD/M) | Lectura de caché | Escritura de caché | Para qué |
|---|---|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | $0.25 | — | El trabajo más difícil |
| Claude Opus 5 | $5 | $25 | — | — | Reemplazado por 5.5 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $5 | Frontera cotidiana |
| Claude Sonnet 5 | $3 | $15 | — | — | Reemplazado por 5.5 |
| Claude Sonnet 5.5 | $2 | $10 | $0.20 | $2.50 | Volumen y agentes |
Opus 5.5 también tiene modo rápido en vista previa, a $8/$40. Anthropic dice que Opus 5.5 cuesta 40% menos que Opus 5 en cargas típicas y que Sonnet 5.5 cuesta hasta 30% menos por tarea que Sonnet 5, porque además de ser más barato por token usa menos tokens. Los dos generan respuestas más de 30% más rápido que su antecesor. Opus 5.5 trae 1 millón de tokens de contexto por defecto y hasta 128,000 de salida; para Sonnet 5.5, el changelog de Claude Code también indica 1 millón de contexto.
Según Anthropic, Sonnet 5.5 saca 70.6% en Terminal-Bench 4.0, por encima de Opus 5.5 (66.4%), y Opus 5.5 mejora a Opus 5 en todas las pruebas publicadas. Las cifras son de Anthropic, medidas por Anthropic: sirven para comparar dentro de la familia, no para decidir por ti.
| Prueba | Opus 5 | Opus 5.5 | Sonnet 5 | Sonnet 5.5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 52.3% | 66.4% | 10.3% | 70.6% |
| CursorBench 4.0 | 46.6% | 57.8% | 34.1% | 55.5% |
| FrontierCode 1.1 | 48.0% | 54.4% | 42.4% | 46.2% (esfuerzo máximo) |
| GDPval-AA v2.1 (Elo) | 1708 | 1846 | 1449 | 1844 |
| OSWorld 2.1 | 74.0% | 81.8% | — | — |
El salto de Sonnet es el dato fuerte: en trabajo de oficina (GDPval) queda a dos puntos de Opus 5.5, y en terminal lo supera. Anthropic describe a Opus 5.5 como "comparable a Claude Fable 5.1 en la mayor parte del trabajo"; Fable sigue arriba en lo más difícil, a dos veces y media el precio.
Se rompen el apagado del pensamiento y tool_choice con tipo any o tool, que ahora devuelven error 400, y la herramienta anterior de uso de computadora. Es lo que hay que revisar antes de cambiar el nombre del modelo en producción. Según las notas de versión:
thinking: {"type": "disabled"} devuelve error 400.thinking: {"type": "between_tools"} con esfuerzo alto o menor, en lugar de disabled.tool_choice con tipo any o tool devuelve 400. La alternativa es auto con uso estricto de herramientas.computer_20251124 ya no se acepta en la API de Claude ni en Google Cloud.Además, desde el 24 de septiembre Anthropic vuelve a cobrar ciertas negativas antes de generar salida (categorías bio, frontier_llm y reasoning_extraction). Si tu aplicación recibe muchas negativas, revisa tu facturación.
| Tarea | Modelo sugerido | Por qué |
|---|---|---|
| Clasificar, extraer, resumir en volumen | Sonnet 5.5 con esfuerzo bajo | El más barato de los nuevos y el más rápido |
| Agentes de código y de terminal | Sonnet 5.5, y Opus 5.5 si falla | Sonnet gana en Terminal-Bench a mitad de precio |
| Análisis largo, redacción delicada, decisiones con contexto enorme | Opus 5.5 | Mejor en OSWorld y FrontierCode; 128K de salida |
| Lo más difícil, donde un error cuesta caro | Fable 5.1 | Sigue arriba; úsalo con tope de esfuerzo |
claude-sonnet-4-5-20250929) se retira el 30 de noviembre de 2026.tool_choice antes de cambiar de modelo, no después del primer error en producción.deniedModels y availableModelsMatch para que un modelo nuevo no entre sin aprobación.En julio escribimos que Opus 5 reordenaba el enrutador porque daba casi lo mismo que Fable 5 a la mitad del costo. Opus 5.5 y Sonnet 5.5 repiten la jugada un escalón más abajo: lo que en julio de 2026 pedía Opus hoy lo resuelve Sonnet, y lo que pedía Fable lo resuelve Opus en la mayoría de los casos. Para una empresa mediana en México, el efecto práctico es que el costo de un agente bien diseñado baja otra vez a la mitad. El riesgo es el de siempre: confiar en la tabla del proveedor en lugar de medir con tus propias tareas.
Artículos relacionados
Claude Fable 5.1 y Mythos 5.1: precio, benchmarks y qué cambia en tu enrutador de modelos
Anthropic lanzó Claude Fable 5.1 y Mythos 5.1 el 1 de septiembre de 2026: $10/$50 por millón de tokens, lectura de caché a $0.25 (75% menos), cinco niveles de esfuerzo y retención cero. Comparativa contra Fable 5 y Opus 5, y cómo decidir si migras.
Claude Opus 5: precio, contexto de 1M y por qué reordena tu router de LLMs
Claude Opus 5 introduce 1M de tokens y rendimiento de frontera a precio accesible. Analizamos costos, benchmarks y cómo reconfigurar tu router de LLMs.
Claude Fable 5 y la generación 5: qué hacer con Opus 4.x
Guía técnica para migrar de Claude Opus 4.x a la generación 5. Compara Fable 5, Sonnet 5 y Mythos, costos por token, latencia y riesgos de producción.
